自动研究:特征发现
梯度提升模型要的是一张数字表,而一条点评是一段话。本篇用问题把这段话变成数字:大模型(DeepSeek)负责提出问题,象信对每一条评论回答这些问题,答案变成数值列,交给 sklearn 的 HistGradientBoostingRegressor 去预测评论者给的星级。
「自动研究」指的是接下来的循环:回归模型报告它用上了哪些问题、哪些评论仍然预测得很差;下一次提问读这份报告,增加、改写或删除问题;然后再跑一轮。整个过程没有一个问题是人手写的。
数据是 500 条大众点评评论,输入评论正文,输出评论者的总评分(1–5 星)。RMSE 以「星」为单位衡量预测误差,越低越好。下表所有数字都来自那 200 条循环从未读过的 test 评论:
| 怎样把评论变成分数 | RMSE | Spearman |
|---|---|---|
| 预测 dev 的平均分 | 0.920 | — |
| TF-IDF(jieba 分词)+ 岭回归 | 0.861 | 0.485 |
| 直接问象信「几星」,再整体平移 +0.33 | 0.607 | 0.773 |
| 第 1 轮的 12 个问题,无循环 | 0.665 | 0.657 |
| 4 轮循环之后的 31 个问题 | 0.659 | 0.650 |
结论和 TypeSafe 原文不一样,我们如实写出来:
- 用问题做特征确实有效:31 个问题的 RMSE 0.659,比 TF-IDF 词袋(0.861)好得多。
- 但在这份数据上,直接问象信一道 5 档「几星」Score 反而最好(0.607)。TypeSafe 的葡萄酒评分里,直接问是 2.15、特征循环是 1.77,特征明显更好;这里正好反过来。
- 4 轮循环相对第 1 轮只改善了 0.006 星,95% 置信区间 [−0.053, +0.041],在噪声之内。
原因很可能在任务本身:点评星级几乎就是评论的整体情感倾向,一道 Score 就能把它读出来;葡萄酒评分则依赖许多专业细节,需要很多窄问题拼起来。另外本文只有 300 条训练样本(原文 1,200 条),梯度提升模型要从 31 列(55 个数值列)里学到「情感」这个总体信号,样本太少,而直接问法根本不需要训练。「讨论」一节给出了改进方向。
环境准备
pip install xiangxin-sdk openai scikit-learn numpy scipy jieba matplotlib
export XIANGXIN_API_KEY="sk-xx-..."
export LLM_BASE_URL="https://api.deepseek.com" LLM_API_KEY="sk-..." LLM_MODEL="deepseek-flash"   # 或自部署的 OpenAI 兼容地址
所有调用缓存在 results/cache.json,重跑不会重复计费。本文运行于 2026-09-25/26,模型 xiangxin-latest;提问者为自部署的 DeepSeek-V4.1-Flash(dsv41-flash,思考模式)。
数据
dirtycomputer/yf_dianping(Hugging Face),即 SophonPlus/ChineseNlpCorpus 整理的大众点评评论数据,约 329 万行,字段为用户、餐馆、总评分、环境 / 口味 / 服务分、时间和评论正文。仓库没有声明许可证,本文仅作研究演示。
prepare_data.py 取正文长度 40–300 字、评分非空、正文不重复的评论(约 273 万条符合),固定种子打乱后取 500 条:前 300 条是 dev(循环只读它们的标签),后 200 条是 test(只在最后评一次)。
| 星级 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 条数 | 13 | 15 | 190 | 224 | 58 |
平均 3.60 星,标准差 0.83,评论平均 112 字。分布集中在 3、4 星,这让「预测平均分」这条基线本身就不算太差(0.920)。一条样本:
没想到龙德广场这里也有新侨三宝乐的面包房,吃完拉面好想吃甜的。 就钻进去买了个奶油卷,面包好硬啊,不过奶油馅很实在,4。5的价格不算便宜啊。 —— 3 星
两种问题
大模型提出的每个问题属于两种之一,种类决定返回什么数字:
intensity(程度) → 一道 Score,固定 5 档量表。它变成两列:期望档位(score),以及答案在各档上的离散程度(标准差)。presence(有无) → 一道 Noul,例如「评论是否提到排队等位」。它变成一列:成立的概率。
INTENSITY_LEVELS = [
    "评论里完全没有涉及",
    "略有涉及——一笔带过",
    "中等程度",
    "明显——评论着重写了这一点",
    "压倒性——评论基本在讲这个",
]
PRESENCE_CRITERIA = {"true": "评论明确说到或清楚暗示了这一点", "false": "评论里看不出这一点"}


def feature_questions(features: list[dict]) -> dict:
    qs = {}
    for f in features:
        if f["kind"] == "intensity":
            qs[f["name"]] = Score(instructions=f["question"], criteria=INTENSITY_LEVELS)
        else:
            qs[f["name"]] = Noul(instructions=f["question"], criteria=PRESENCE_CRITERIA)
    return qs


def encode(f, probs):
    """一道题的概率 → 数值列。Score:期望档位 + 标准差;Noul:一个概率。"""
    if f["kind"] == "presence":
        return [(f["name"], probs[:, 0])]
    lv = np.arange(probs.shape[1])
    mean = probs @ lv
    var = probs @ (lv**2) - mean**2
return [(f["name"], mean), (f"{f['name']}_sd", np.sqrt(np.clip(var, 0, None)))]一轮里所有问题放进同一个请求,一条评论一次调用。所以多问一道题不增加请求数,只多几十个输入 token——这正是并行提问和扇出的思路。
方法
questions <- {}
每一轮:
    评论 <- 第 1 轮:按分数均匀取 40 条 dev 评论
            之后:预测最差的 20 条 + 最准的 20 条,附带本轮与上一轮的预测
    actions <- 大模型(任务说明, 现有问题, 这些评论, 重要度与误差)
    对全部 500 条评论,用象信回答本轮所有新问题(每条一次请求)
    新增的问题:只要这一列不是几乎恒定,就收下
    改写的问题:重新拟合,dev 误差下降才替换
    删除的问题:重新拟合,dev 误差下降才删
out_of_fold <- dev 上 5 折 × 3 次重复的交叉验证预测提问者读到的任务说明是本篇唯一一段「知道这是点评」的文字(PROPOSER_TASK),换成你自己的标签和文本,其余代码不用改。开头几行:
你在为一个梯度提升回归模型设计数值特征。模型只根据一条大众点评评论的正文,
预测评论者给这家店的总评分(1–5 星)。模型除了你设计的特征什么都看不到。

最多返回 12 个动作(actions),每个动作是下面之一:
  ...
回归模型固定为:
HGB = dict(max_iter=300, learning_rate=0.05, max_leaf_nodes=15, min_samples_leaf=10, random_state=0)特征重要度用 sklearn 的置换重要度(permutation_importance,以 RMSE 计),一道 Score 题的两列加回到一起,再归一化成占比,写进下一轮给提问者的反馈里。
基线:直接问几星
最省事的做法是不做特征工程,直接问象信一道 5 档 Score:
STAR_LEVELS = [
    "1 星:很差,基本是在批评",
    "2 星:较差,不满多于满意",
    "3 星:一般,有好有坏",
    "4 星:不错,总体满意",
    "5 星:很好,强烈推荐",
]

r = client.system_one(
    state=comment,
    questions={"stars": Score(instructions="只看这条评论的内容,评论者会给这家店打几星?", criteria=STAR_LEVELS)},
)
predicted = 1 + r.answers["stars"].score      # 第 0 档 = 1 星
原始预测在 test 上 RMSE 为 0.669。象信的期望分整体偏低——题目里没有任何信息告诉它这批评论者习惯怎么打分——所以再加一个在 dev 上量出的平移量 +0.33(dev 真实平均分减去预测平均分),这是这条基线从标签里学到的唯一一个数,之后 RMSE 为 0.607,Spearman 秩相关 0.773。500 次调用共 87,586 个输入 token,按 ¥0.042 / 百万 token 计约 ¥0.0037。
另一条基线是经典的词袋:jieba 分词后做 TF-IDF(在 dev 上拟合,词表 1,485 个),岭回归(RidgeCV 选出 α = 3.16),test RMSE 0.861。300 条训练样本对词袋来说太少,这是它表现差的主要原因;这也正是「问题 → 特征」在小样本时的优势所在:每一列都是一个语义判断,不需要从几百条样本里学会每个词的含义。
自动研究循环
提问者是自部署的 DeepSeek-V4.1-Flash(vLLM,思考模式打开)。本次真实运行的输出(results/run.log):
第 1 轮:12 新增,0 修改,0 删除
  新增  overall_positive、overall_negative、taste_positive、taste_negative、service_positive、
        service_negative、value_positive、price_complaint、environment_positive、hygiene_issue、
        wait_negative、recommend_return
  -> 12 个特征,dev CV RMSE 0.637

第 2 轮:7 新增,5 修改,0 删除
  新增  return_refusal、quality_decline、off_topic_negative、product_positive、convenience_positive、
        activity_experience_positive、subjective_hedge
  reject overall_satisfaction              替换 overall_positive 会使 CV +0.004
  reject overall_dissatisfaction           替换 overall_negative 会使 CV +0.006
  revise return_intent                     替换 recommend_return,CV 0.637 -> 0.634
  reject environment_facility_positive     替换 environment_positive 会使 CV +0.006
  reject hygiene_negative                  替换 hygiene_issue 会使 CV +0.001
  -> 19 个特征,dev CV RMSE 0.634

第 3 轮:6 新增,5 修改,1 删除
  新增  repeat_patronage、portion_positive、portion_negative、social_occasion_positive、
        food_safety_issue、comparative_positive
  revise personal_fit_hedge                替换 subjective_hedge,CV 0.643 -> 0.628
  reject cleanliness_issue                 替换 hygiene_issue 会使 CV +0.008
  reject ambience_positive                 替换 environment_positive 会使 CV +0.007
  reject deal_value_positive               替换 value_positive 会使 CV +0.005
  reject expectation_decline_negative      替换 quality_decline 会使 CV +0.006
  keep   off_topic_negative                删掉会使 CV +0.003
  -> 25 个特征,dev CV RMSE 0.628

第 4 轮:6 新增,6 修改,0 删除
  新增  lukewarm_praise、promotion_deal_positive、minor_complaint_mitigated、
        strong_enthusiasm_positive、comparative_negative、freshness_quality_positive
  reject personal_fit_hedge                替换 personal_fit_hedge 会使 CV +0.015
  revise off_topic_negative                替换 off_topic_negative,CV 0.641 -> 0.639
  reject food_safety_issue                 替换 food_safety_issue 会使 CV +0.003
  reject hygiene_issue                     替换 hygiene_issue 会使 CV +0.000
  revise return_refusal                    替换 return_refusal,CV 0.639 -> 0.631
  revise leisure_experience_positive       替换 activity_experience_positive,CV 0.631 -> 0.630
  -> 31 个特征,dev CV RMSE 0.630
(同一轮里 CV 会先因新增问题上升,再因修改下降,所以某行的「CV a -> b」起点可能高于上一轮末尾。)
每轮结束时的问题集,在 dev(交叉验证)与 test(循环从未读过)上的 RMSE:
| 轮次 | 问题数 | dev CV RMSE | test RMSE |
|---|---|---|---|
| 1 | 12 | 0.637 | 0.665 |
| 2 | 19 | 0.634 | 0.657 |
| 3 | 25 | 0.628 | 0.651 |
| 4 | 31 | 0.630 | 0.659 |
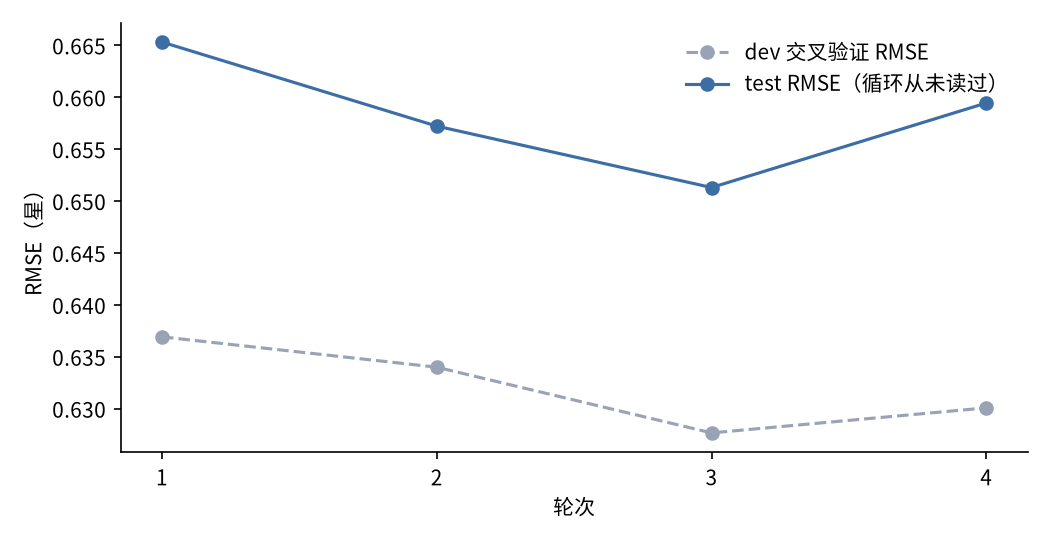
两条线都在 0.63–0.67 这个很窄的区间里,第 4 轮比第 3 轮略有回升。用配对自助法(在 200 条 test 上重抽 2,000 次)比较第 1 轮与第 4 轮:−0.006 星,95% CI [−0.053, +0.041],区间跨过 0,循环带来的改进不显著。
和原文一样,提问者从「加问题」逐渐转向「改问题」:第 4 轮 6 次修改里有 3 次被拒绝(dev 误差没有下降)。
模型用了哪些问题
最终 31 个问题里 24 个是 Score、7 个是 Noul。置换重要度占比前几名:
| 问题 | 题型 | 重要度占比 |
|---|---|---|
| return_refusal | Noul | 10.2% |
| personal_fit_hedge | Noul | 6.4% |
| portion_negative | Score | 5.5% |
| price_complaint | Score | 5.1% |
| social_occasion_positive | Score | 4.5% |
| strong_enthusiasm_positive | Score | 4.5% |
| taste_negative | Score | 4.2% |
| overall_positive | Score | 4.1% |
排第一的是第 2 轮加入、第 4 轮改写过的一道 Noul:
return_refusal:评论是否表达不会再来、不推荐、以后不再光顾、劝别人换一家、不再吃或放弃这家店?
第二名是一个人很难先想到的问题:「评论是否把评价限定在个人偏好或自身条件上(口味不合、不是我的菜……),从而使评分偏保守」——这正是循环读了预测最差的评论之后提出来的。
调用量与成本
| 调用次数 | token | 成本 | |
|---|---|---|---|
| 象信(循环 4 × 500 + 基线 500) | 2,500 | 输入 2,818,930 | ¥0.118 |
| DeepSeek 提问者(思考模式) | 4 | 输入 20,609 / 输出 37,485 | ¥0.34(按官方价目折算) |
DeepSeek 跑在自部署的 vLLM 上,成本按 DeepSeek 官方 API 价目折算(deepseek-flash 高峰时段,输入 ¥2 / 百万、输出 ¥8 / 百万,2026-09-25 查询)。请求数随行数增长,而不是随问题数增长:一轮里无论问 3 道题还是 30 道题,都是每条评论一次请求;一次改写也算一道新题,需要对所有行再答一遍。
讨论
- 先看最便宜的基线。 这份数据上,一道「几星」的 Score 就把误差从 0.920 降到 0.607,而 4 轮特征发现停在 0.659。如果目标只是一个分数,直接问就够了。特征发现的价值在于可解释的列(「不会再来」「分量少」「价格抱怨」各占多少),以及在单一问题不够用的任务上(如 TypeSafe 原文的葡萄酒评分)继续压低误差。
- 为什么这里不如直接问。 300 条训练样本、55 个数值列,梯度提升很难把这么多局部信号重新拼回「整体满意度」;而且星级高度依赖整体情感,这恰好是一道 Score 最擅长直接读出的。最直接的改进是把「几星」本身作为一列并入特征集(见下一步),让模型在它之上学残差。
- dev 与 test 分开。 循环反复读同样的 300 条 dev 评论,并按它们上面的误差决定去留;dev CV 从 0.637 降到 0.630,test 却几乎不动,说明这点下降主要是对 dev 的拟合。所以 200 条 test 只在最后评一次。
- 样本量小。 200 条 test 上的抽样波动约 ±0.05 星,本文所有循环内的差异都比它小。
- 点评星级的上限。 同一段文字,不同用户打 3 星还是 4 星本就有很大随意性;这部分误差任何只读正文的模型都消除不了。
下一步
- 在花钱回答之前先筛问题:把候选问题本身当作 state,问几道 Noul——能否从评论原文判断、在不同评论之间会不会有差异——只发送通过的。
- 把基线的「几星」Score 作为第 0 列并入(本文最值得先做的一步),再看发现的问题还能补充多少;TF-IDF 同理。
- 加大 dev 样本(例如 2,000 条),并在循环外做更多次重复,缩小置信区间。
- 换一个回归器(弹性网、随机森林)检查发现的特征是否只对梯度提升有用。
- 用多个随机种子或不同数据切片重复发现过程,只保留稳定有用的问题。
完整代码
https://github.com/xiangxinai/xiangxin-cookbooks/tree/main/autoresearch_feature_discovery
prepare_data.py:从 yf_dianping 抽 500 条评论(data/reviews.jsonl)main.py:基线、自动研究循环、评估与作图;所有调用缓存在results/cache.jsonresults/baselines.json、results/summary.json、results/run.log:本页所有数字的原始输出