

函数调用
去奶茶店点一杯「大杯、少冰、三分糖、加椰果」,店员不会把整句话抄下来,而是在杯子上勾四个选项。这篇手册对一个 A 股行情助手做同样的事:一句中文指令进来,出去的是一个函数名加一组参数,每个参数都是从固定列表里选出来的值,并带着置信度。
「画一下最近一个月宁德时代和沪深300的滚动相关性」
    rolling_correlation(symbol='300750', benchmark='510300', window='1mo')   置信度 0.52

「对比一下茅台、招行和平安最近三个月的走势」
    compare_returns(symbols=['600519', '600036', '601318'], window='3mo')    置信度 0.54

「这个月大盘整体怎么样」
    market_summary(window='1mo')                                              置信度 0.91

「你们能查哪些股票」
    list_symbols()                                                            置信度 0.99
函数本身一行不改。它们的参数本来就只能取固定列表里的值,也就是 Python 的 Literal:
def plot_price(
    symbol: Literal["510300", "600519", "300750", "600036", "002594", "601318"],
    style: Literal["line", "candles"] = "line",
    resolution: Literal["1d", "1w", "1mo"] = "1d",
    window: Literal["1w", "1mo", "3mo", "6mo", "1y"] = "3mo",
    include_volume: bool = False,
    moving_average: Literal["5", "20", "60"] | None = None,
    log_scale: bool = False,
): ...取值来自固定列表的参数叫封闭集合。每个封闭集合参数对应一道 Choice,选项正好是列表里的值,所以传进函数的一定是函数认得的值,不会出现拼错的代码或不存在的周期。你要补的只是一份 spec:用中文说清每个参数、每个选项是什么意思。
结论先行: 在 60 条带标注的中文指令上,象信一号选对函数 98.3%,函数选对时逐个参数正确 95.5%,整次调用(函数名 + 全部参数,补齐默认值后逐项比较)完全正确 83.3%。置信度把好坏分得开:只自动执行置信度 ≥ 0.8 的指令(占 30%),这部分 18 条全对;阈值放到 0.7,自动执行一半,正确率 96.7%。每条指令一次请求、约 3,800 个输入 token,60 条总计 ¥0.0096。
环境准备
pip install xiangxin-sdk pandas numpy matplotlib
export XIANGXIN_API_KEY="sk-xx-..."
代码分三个文件(完整代码见文末链接):
trader.py:十个普通函数和行情数据;dispatch.py:读取签名和 spec、构造问题、把答案还原成一次函数调用;main.py:跑示例指令和评测,原始答案写入results/。
数据
行情:6 只标的(沪深300ETF 510300、贵州茅台 600519、宁德时代 300750、招商银行 600036、比亚迪 002594、中国平安 601318)2025-09-01 至 2026-09-24 的前复权日 K 线,每只 260 根,共 1,560 行。数据取自腾讯财经公开行情接口(fetch_data.py 可复现下载),仅用于演示,不构成投资建议。
指令:60 条中文指令及其标注(14 条示例 + 46 条评测),示例数据为本文构造,放在 data/commands.json。标注只写用户明确说出的参数,比较时两边都补齐函数默认值再逐项对比,所以「日线」写不写 resolution='1d' 都算对。
["宁王周K,一年,带成交量", "plot_price",
 {"symbol": "300750", "resolution": "1w", "window": "1y", "include_volume": true}]
从签名里找出封闭集合
类型标注已经说明了哪些参数来自固定列表、列表里有什么。closed_sets 读一个签名,把这些参数分成三种形状:
- choice:
Literal[...],从列表里选一个; - set:
list[Literal[...]],选任意多个; - flag:
bool,开或关。
import inspect, types, typing
from typing import Literal

def closed_sets(fn):
    hints = typing.get_type_hints(fn)
    out = {}
    for name in inspect.signature(fn).parameters:
        t = hints.get(name)
        origin = typing.get_origin(t)
        if origin in (typing.Union, types.UnionType):          # Literal[...] | None
            inner = [a for a in typing.get_args(t) if a is not type(None)]
            t, origin = inner[0], typing.get_origin(inner[0])
        if origin is Literal:
            out[name] = ("choice", typing.get_args(t))
        elif origin is list and typing.get_origin(typing.get_args(t)[0]) is Literal:
            out[name] = ("set", typing.get_args(typing.get_args(t)[0]))
        elif t is bool:
            out[name] = ("flag", (True, False))
    return out
十个函数的结果:
  list_symbols        0
  market_summary      1  window:choice
  plot_price          7  symbol:choice, style:choice, resolution:choice, window:choice, include_volume:flag, moving_average:choice, log_scale:flag
  weekday_pattern     3  symbol:choice, window:choice, metric:choice
  compare_returns     3  symbols:set, window:choice, normalize:flag
  rolling_correlation 4  symbol:choice, benchmark:choice, window:choice, resolution:choice
  summary_stats       2  symbol:choice, window:choice
  volatility          3  symbol:choice, window:choice, annualized:flag
  top_movers          2  window:choice, direction:choice
  drawdown            3  symbol:choice, window:choice, plot:flag

共 28 个可填参数
top_movers 说明了哪些参数会被跳过:它的第三个参数 limit: int = 3 不是封闭集合,不提问,保持默认值。自由文本、数字、日期都一样处理:不问,函数默认值生效。
写 spec
Literal 只告诉你字符串 "1mo" 和 "3mo",不会告诉你用户说「这个季度」指的是后者。spec 负责说清这些:每个函数一句描述,每个参数一个问题,每个选项一行解释,外加一道在十个函数之间选择的问题。它放在 spec.json 里,也可以让大模型根据签名先起草一版。
"style": {
  "question": "用户想要普通折线还是 K 线(蜡烛图)?",
  "stated": "用户的指令里有没有提到图的画法,例如“K线”“蜡烛图”“折线”?",
  "options": {
    "line": "一条连接收盘价的折线",
    "candles": "K 线 / 蜡烛图,显示每根 K 线的开高低收"
  }
},
"moving_average": {
  "question": "要叠加的均线是几日均线:5 日、20 日还是 60 日?",
  "stated": "用户的指令里有没有提到均线,例如“5日线”“20日均线”“MA60”?",
  "options": {
    "5": "5 日均线,短期、快线",
    "20": "20 日均线,月线级别",
    "60": "60 日均线,季线、慢线"
  }
}
几点约定:
- 选项键就是函数接受的字符串,答案不需要再映射回参数值。
stated让参数变成可选的。 它是一道额外的 Noul,问指令里有没有提到这个参数。答「没有」时,调用里不写这个参数,由函数自己的默认值决定。- set 参数的问题按成员展开。
"用户是否在指令里点名要比较 {},或者说了要比较全部标的?"中的{}换成每只标的,得到 6 道 Noul。 - 股票列表和时间窗口是共享的,在 spec 里写一次,用
"$symbols"、"$windows"引用。选项说明里写上口语叫法(「宁王」「招行」「大盘」「这个季度」),因为匹配靠的是语义。 - 问题要写意思,别写参数名。
"用哪个 resolution?"没有给模型任何可以对照的东西;"每根 K 线代表多长时间:一天、一周还是一个月?"才有。
把 spec 变成问题
Dispatcher 在初始化时把 spec 展开成一组问题,之后每条指令只发一次请求:选函数的 Choice,加上所有函数所有参数的问题。答案回来后,只读被选中那个函数的部分。
from xiangxin import Choice, Noul

ROUTE = "__tool__"

class Dispatcher:
    def __init__(self, spec, tools, client, model="xiangxin-latest"):
        self.spec, self.tools, self.client, self.model = spec, tools, client, model
        self.questions = {
            ROUTE: Choice(
                instructions=spec["route"],
                criteria={n: f["description"] for n, f in spec["functions"].items()},
            )
        }
        for fname, fn in tools.items():
            argspec = spec["functions"][fname]["arguments"]
            for arg, (shape, _) in closed_sets(fn).items():
                a, qid = argspec[arg], f"{fname}.{arg}"
                if shape == "choice":
                    self.questions[qid] = Choice(instructions=a["question"], criteria=_resolve(a["options"], spec))
                    if "stated" in a:
                        self.questions[qid + "?"] = Noul(instructions=a["stated"])
                elif shape == "set":
                    for member, desc in _resolve(a["options"], spec).items():
                        self.questions[f"{qid}.{member}"] = Noul(
                            instructions=a["question"].format(f"{member}({desc})"))
                else:  # flag
                    self.questions[qid] = Noul(instructions=a["question"])

    def __call__(self, command):
        resp = self.client.system_one(state=command, questions=self.questions, model=self.model)
        return self.read(resp.answers)
read 按形状把答案还原成参数,并给每个参数一个概率:
| 形状 | 取值 | 概率 |
|---|---|---|
| choice(必填) | 概率最高的选项 | 该选项的概率 |
choice(有 stated) | stated ≥ 0.5 时取最高选项,否则省略 | 提到时为 stated × 选项概率,省略时为 1 − stated |
| set | 所有 ≥ 0.5 的成员 | 各成员 max(p, 1−p) 的最小值 |
| flag | p ≥ 0.5 | max(p, 1−p) |
每条指令 49 个问题,其中
  __tool__                        choice  用户想让行情助手做哪件事?
  plot_price.style                choice  用户想要普通折线还是 K 线(蜡烛图)?
  plot_price.style?               noul    用户的指令里有没有提到图的画法……
  compare_returns.symbols.600519  noul    用户是否在指令里点名要比较 600519(贵州茅台,白酒龙头)……
49 个问题加一句指令,一次请求约 3,820 个输入 token。
跑十四条指令
每条指令一行结果;置信度 是这次调用里最没把握的那个判断,函数 是选中函数的概率。
from xiangxin import XiangxinClient

assistant = Dispatcher(SPEC, TOOLS, XiangxinClient())
for command in COMMANDS:
    call = assistant(command)
print(f"「{command}」\n {call} 置信度 {call.confidence:.2f} 函数 {call.tool.probability:.2f}")「茅台 周线」
plot_price(symbol='600519', resolution='1w') 置信度 0.62 函数 0.76
「画一下最近一个月宁德时代和沪深300的滚动相关性」
rolling_correlation(symbol='300750', benchmark='510300', window='1mo') 置信度 0.52 函数 0.99
「招行一般星期几成交最活跃」
weekday_pattern(symbol='600036', metric='volume') 置信度 0.71 函数 0.96
「这周谁涨得好」
top_movers(window='1w', direction='gainers') 置信度 0.80 函数 0.80
「你们能查哪些股票」
list_symbols() 置信度 0.99 函数 0.99
「这个月大盘整体怎么样」
market_summary(window='1mo') 置信度 0.91 函数 0.99
「比亚迪K线,加上20日均线」
plot_price(symbol='002594', style='candles', moving_average='20') 置信度 0.70 函数 1.00
「对比一下茅台、招行和平安最近三个月的走势」
compare_returns(symbols=['600519', '600036', '601318'], window='3mo') 置信度 0.54 函数 0.98
「宁王波动大吗」
volatility(symbol='300750') 置信度 0.72 函数 0.98
「最近一周跌得最惨的是哪几个」
top_movers(window='1w', direction='losers') 置信度 0.79 函数 0.95
「茅台今年以来最大回撤多少,顺便画个图」
drawdown(symbol='600519', window='1y', plot=True) 置信度 0.66 函数 0.93
「平安最近一个月的数据」
summary_stats(symbol='601318', window='1mo') 置信度 0.63 函数 0.63
「给我看招商银行的日线,带成交量」
plot_price(symbol='600036', resolution='1d', include_volume=True) 置信度 0.67 函数 1.00
「比亚迪最近是不是跟着宁德时代走」
rolling_correlation(symbol='002594', benchmark='300750') 置信度 0.57 函数 0.86十四条全部正确。几条值得看:
- 「画一下最近一个月宁德时代和沪深300的滚动相关性」一句话填了三个参数。
symbol和benchmark取自同一组 6 只标的,能各就各位,是因为两道问题写清了角色:「被衡量的那一只(先提到的)」和「作为参照的尺子(后提到的)」。 - 「对比一下茅台、招行和平安最近三个月的走势」把三只放进了集合,另外三只留在外面。
- 「宁王」「招行」「平安」「大盘」都是口语叫法,靠的是选项说明里写了别名。
执行其中几条(函数就是普通 Python 函数,call.run() 直接调用):
「这个月大盘整体怎么样」 -> market_summary(window='1mo')
近 1mo 行情一览
  600036 招商银行         40.69    2.24%    13,491,484 手
  510300 沪深300ETF      4.51   -2.94%   143,211,014 手
  601318 中国平安         53.25   -3.45%    13,284,473 手
  600519 贵州茅台       1237.00   -5.05%       519,811 手
  002594 比亚迪          84.34   -8.42%     5,473,871 手
  300750 宁德时代        293.50  -22.56%     7,202,018 手

「最近一周跌得最惨的是哪几个」 -> top_movers(window='1w', direction='losers')
近 1w 跌幅前 3
  300750 宁德时代      -3.55%  ->  293.50
  600519 贵州茅台      -2.37%  ->  1237.00
  002594 比亚迪       -0.74%  ->  84.34

「画一下最近一个月宁德时代和沪深300的滚动相关性」 -> rolling_correlation(symbol='300750', benchmark='510300', window='1mo')
300750 与 510300 的 1mo 滚动相关系数(1d 收益率):最新 0.20,区间 -0.23 ~ 0.92
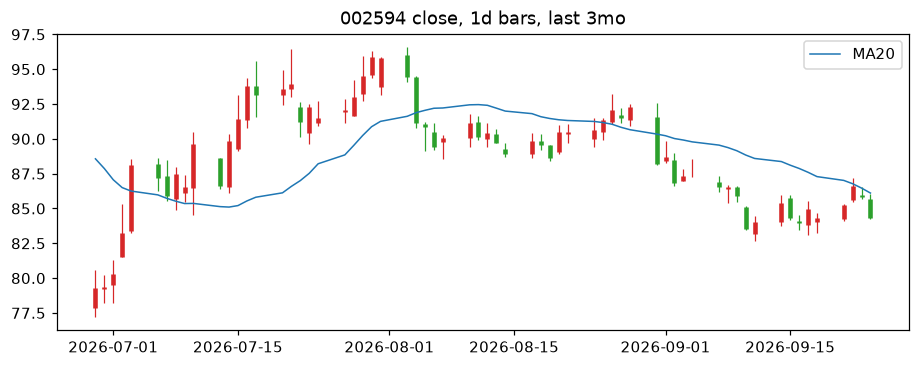
「比亚迪K线,加上20日均线」画出的图(窗口没提,用默认的 3 个月;A 股习惯红涨绿跌):
读懂置信度
confidence 取整次调用里最弱的那个判断,而不是所有判断概率的乘积。一个参数错了整次调用就错了,看最弱一环最直接;乘积回答的是另一个问题(「每一项都对的概率」),而且参数越多乘积越小,不管其中有没有哪个判断真的不稳。
逐个参数看一条的置信度从哪来:
call = assistant("比亚迪最近是不是跟着宁德时代走")
for name, a in call.arguments.items():
...「比亚迪最近是不是跟着宁德时代走」 -> rolling_correlation(symbol='002594', benchmark='300750') 置信度 0.57
symbol '002594' p 0.57 002594 0.57 300750 0.42 510300 0.01
benchmark '300750' p 0.93 300750 0.93 002594 0.06 510300 0.01
window 未提及,用默认值 p 0.91
resolution 未提及,用默认值 p 0.92
最弱的一环:symbol答案是对的,但 symbol 只有 0.57:模型在「比亚迪跟着宁德时代」里谁是被衡量的、谁是参照上有些犹豫,这正是这句话本身的歧义所在。window 和 resolution 都被省略,因为「最近」没说多长、也没说用日线还是周线,于是函数用自己的默认值(3 个月、日收益率)。这就是 stated 问题的作用:没有它,window 那道 Choice 也得选出某个窗口,而且会选得很笃定。
评测:60 条带标注的指令
示例之外,再加 46 条覆盖十个函数的指令,一共 60 条,逐条和标注比对。
spec 的第一版和第二版。 第一版的 stated 问题写得很笼统,比如「用户是否说了要看多长一段时间?」。跑下来,大部分错误都是「用户明明说了『这个月』『三个月』,却被判成没提」,于是参数被省略、默认值顶上。第二版只改了 stated 问题(以及 set 成员的问法),在问题里列出几种常见说法,比如「用户的指令里有没有提到时间范围,例如『这周』『这个月』『三个月』『这个季度』『半年』『今年』『一年』?」。其余部分(函数描述、选项说明、代码)完全不变。
| 指标 | spec 第一版 | spec 第二版 |
|---|---|---|
| 选对函数 | 98.3% | 98.3% |
| 参数逐个正确(函数选对时) | 92.5% | 95.5% |
| 整次调用完全正确 | 73.3% | 83.3% |
| 正确调用的平均置信度 | 0.66 | 0.73 |
| 错误调用的平均置信度 | 0.53 | 0.50 |
| 平均输入 token / 请求 | 3,458 | 3,817 |
注意
第二版是看了第一版在这 60 条上的错误之后改的,第二版的数字属于「样本内」结果,会比在新指令上的表现偏乐观。改动本身是通用的(把笼统的问题写具体),没有针对某条指令加规则,但真正上线前应该另留一批指令做验证。
按置信度分流。 这才是这套做法的用处:高置信度的直接执行,低置信度的弹出确认框(「您是想看比亚迪的周 K 吗?」)。第二版 spec 下:
| 阈值 | 自动执行 | 其中完全正确 |
|---|---|---|
| 0.0(全部执行) | 60 / 60(100%) | 83.3% |
| 0.5 | 54 / 60(90%) | 88.9% |
| 0.6 | 39 / 60(65%) | 94.9% |
| 0.7 | 30 / 60(50%) | 96.7% |
| 0.8 | 18 / 60(30%) | 100.0% |
| 0.9 | 7 / 60(12%) | 100.0% |
剩下的 10 个错误(第二版)分三类:
- 集合参数漏选(4 条)。 「比较宁德时代和比亚迪今年的表现」只选了比亚迪;「茅台 vs 沪深300,一个月,起点对齐」只选了茅台;「六只全部对比一下半年走势」只选了 510300。每个成员是一道独立的 Noul,模型对「点名了几只」判断偏保守,这是本次评测里最弱的一环。
- 两个同类参数混淆(2 条)。 「宁德时代和比亚迪一年的滚动相关系数」把
benchmark选成了沪深300;「平安和沪深300是不是同涨同跌」把symbol和benchmark都选成了平安,函数会算出一只股票和它自己的相关系数。这类错误可以在代码里加一条规则兜底(两者相同就转人工)。 - K 线周期和其他(4 条)。 「宁王周K」没识别出周线;「平安的蜡烛图,最近一周」「茅台近一周K线」把「一周」同时当成了窗口和周线;「比亚迪哪天振幅最大」被路由到了
volatility(振幅和波动率在语义上确实接近)。
这些错误的置信度大多偏低:10 条里有 8 条低于 0.6,阈值设在 0.6 时这 8 条都会被拦下来转人工确认。
成本与耗时。 每条指令一次请求,第二版 60 条共 229,041 个输入 token,按 ¥0.042 / 百万输入 token 计算共 ¥0.0096,约合每条 ¥0.00016。评测时后端只有一个模型副本在线,同时还在承接其他批量任务,请求的模型耗时中位数为 5.3 秒,端到端中位数 6.3 秒,这反映的是当时的排队情况,不代表空载延迟。
大模型基线
仓库里的 llm_baseline.py 用同一份签名和 spec 自动生成 JSON Schema(Literal → enum),让 DeepSeek 用原生 tool calling 跑同样 60 条指令并按同一标准打分。本文撰写时基线尚未运行,结果待补。
讨论
为什么有效。 函数调用里真正要判断的东西,大部分本来就是封闭集合:调哪个函数、哪只股票、多长窗口、日线还是周线。把每一个都变成 Choice 或 Noul,模型只在合法值之间分配概率,永远不会生成函数不认的参数;每个参数都带概率,你就能知道哪一个参数不稳,而不只是「这次调用可能不对」。
stated 是关键设计。 普通的 tool calling 常见的毛病是「用户没说,模型替他编一个」。stated 把「用户说了什么」和「说的是哪个值」拆成两个问题,没说就用默认值。本文从第一版到第二版的提升几乎都来自把 stated 问题写具体,说明这类元问题的措辞很重要。
局限:
- 集合参数是短板。 按成员逐个问 Noul,在本次评测里漏选明显。成员很多或需要「全部」这类概括说法时,可以额外加一道「用户是否要比较全部标的」的 Noul,或者改成先问数量再问成员。
- 只能处理封闭集合。 金额、数量、日期、自由文本不提问,用函数默认值。真的需要这些值时,要先用别的方法抽出来(例如 预解析值抽取),再用象信核对。
- 所有函数的问题一起发。 本例 49 个问题约 3,800 token,十个函数还可以接受;函数多到上百个时,可以先用一次请求只问
__tool__,再对选中的函数单独问参数(多一次往返,token 少得多),见 意图路由。 - 象信一号 1.0 是 9B 模型,在「谁是主语、谁是参照」这类需要细读句法的判断上不如大模型稳,见 象信一号 1.0 的能力边界。
什么时候不该这么用: 参数大多是自由文本(写邮件、搜索关键词)、或者函数需要多轮对话补全信息时,直接用大模型的 tool calling 更合适。本文的做法适合参数空间有限、调用量大、需要知道「哪一步没把握」再决定是否自动执行的场景。更多分流做法见 置信度 和 按置信度路由。
完整代码
https://github.com/xiangxinai/xiangxin-cookbooks/tree/main/function_calling
fetch_data.py:下载行情数据trader.py、dispatch.py、spec.json、spec_v2.jsonmain.py:python main.py --spec spec_v2.json调 API;加--replay从results/answers_*.jsonl重放本文结果,不再调用 APIllm_baseline.py:大模型 tool calling 基线(需要LLM_API_KEY)results/:原始答案、逐条评测结果与汇总