

基于置信度的分类
每家上市公司都会在年报里介绍自己做什么生意。我们把这段介绍分到中国上市公司协会上市公司行业分类的 91 个行业大类里,每家公司只问一个 Choice。这套分类由 GB/T 4754-2017《国民经济行业分类》的门类、大类裁剪而来。
多数公司不难分:一家煤矿就是煤矿,一家纸厂就是纸厂。但也有难分的公司:做园区开发、又有大宗贸易的「外高桥」,做金属粉末、产品卖给电子厂的「悦安新材」,还有年报开篇先讲两页行业形势、主营业务放在后面的公司。不管难易,模型都得选一个大类,而难题的答案和容易题的答案看上去没有区别。要把两者分开,通常就得花钱:再调一个模型、多问几次,或者请人复核。
其实 Choice 本身已经给出了信号。它在返回首选项的同时还返回 confidence:概率集中在一个选项上时高,分散在几个选项上时低。用这一个数,就能把可以直接用的答案和需要多看一眼的答案分开。
对于拿不准的答案怎么处理,取决于标签体系。行业分类是一棵树:大类往上归到中间组(制造业的 31 个大类分成「食品、饮料、烟草」「电气、电子及通讯」等 10 组),再往上是门类。所以拿不准时,报告它的上一级就行。上一级由大类直接推出,不需要再发请求。
在 160 家公司上,置信度阈值取 0.2 时正好分成两半。有把握的 85 家,大类准确率 75%;没把握的 75 家只有 51%,改报上一级后升到 63%。最后得到一个 classify() 函数,它返回一个标签和这个标签的粒度,每家公司只需一次请求。
年报摘要「主要业务」一节 ──► 一次请求:Choice(91 个行业大类)──► confidence ≥ 0.2 ?
                                                              ├─ 是 → 报告大类,例如 C22 造纸和纸制品业
                                                              └─ 否 → 报告上一级,例如 CD 造纸、印刷、文教
环境准备
pip install xiangxin-sdk pandas matplotlib
# 准备数据还需要:
pip install akshare pypdf
export XIANGXIN_API_KEY="sk-xx-..."
所有象信调用都缓存在 results/cache.json,重跑时直接读缓存,不再计费;删掉这个文件就会重新调用。下文数字来自 xiangxin-1.0.0,运行日期 2026-09-25。
import json
from collections import defaultdict
from pathlib import Path

import pandas as pd
from xiangxin import Choice, RetryPolicy, XiangxinClient

MODEL = "xiangxin-latest"
CONFIDENT = 0.2   # 不低于它就报告大类,否则报告上一级(取值见下文)
MAX_CHARS = 1500  # 只把前 1500 字送进去

client = XiangxinClient(retry=RetryPolicy(max_retries=12, backoff_max=30.0))
两层分类表
taxonomy_capco.csv 是巨潮资讯公开的「中国上市公司协会上市公司行业分类」(分类标准编码 008001),共有 19 个门类、91 个大类、456 个中类。制造业下面还多一层中间组 CA–CJ。每个大类都有一个父节点:制造业大类的父节点是所在的中间组,其他大类的父节点直接就是门类。这样算下来,91 个大类只归到 28 个父节点。
这两层都能从这一张表里直接读出来,不需要模型参与:
tax = pd.read_csv("data/taxonomy_capco.csv", dtype=str)
tax = tax[tax["终止日期"].isna()]
NAME = dict(zip(tax["类目编码"], tax["类目名称"]))
PARENT = dict(zip(tax["类目编码"], tax["父类编码"]))
LEVEL = dict(zip(tax["类目编码"], tax["分级"].astype(int)))

GROUPS = sorted(c for c, lv in LEVEL.items() if lv == 2)  # 91 个大类,如 C15
CHILDREN = defaultdict(list)
for code, parent in PARENT.items():
    CHILDREN[parent].append(code)


def parent_of(group: str) -> str:
    """大类的上一级:制造业大类是 CA–CJ 中间组,其他大类是门类。"""
    return PARENT[group]
每个选项都需要一段描述。单看大类名称不一定够清楚,所以描述里列出它下面的中类(最多 8 个)。读年报的人本来也是这样对照的。选项的键写成「编码 + 名称」,因为模型会读到键名。
def describe(group: str) -> str:
    inside = [NAME[c] for c in sorted(CHILDREN[group])][:8]
    return "包括:" + ";".join(inside) if inside else NAME[group]


OPTIONS = {f"{g} {NAME[g]}": describe(g) for g in GROUPS}91 个大类,28 个上一级节点,19 个门类
C15 的选项描述:C15 酒、饮料和精制茶制造业 → 包括:酒的制造;饮料制造;精制茶加工数据:160 份年报摘要
prepare_data.py 先从沪深两市的 A 股代码里用固定种子随机抽样,再逐家公司做三件事:
- 从巨潮资讯读取它当前的上市公司协会行业分类(大类);
- 下载它的《2025 年年度报告摘要》PDF;
- 截取摘要里「报告期主要业务或产品简介」一节(沪市摘要写作「报告期公司主要业务简介」)。
这一节是公司用自己的话写的「我们做什么」,作用相当于美股 10-K 里的 Item 1 "Business"。按抽样顺序看,前 179 家里有 19 家没有 2025 年报摘要、行业标签或这一节,跳过后留下 160 家。
有一件事要先说清楚:很多公司在这一节里会直接写出自己的行业分类,例如「根据《上市公司行业分类指引》,公司属于酒、饮料和精制茶制造业(C15)」。如果不处理,就等于把答案写进了题目。所以 prepare_data.py 会删掉所有含「行业分类」「分类指引」「所属行业」或形如「(C15)」编码的句子。
标签本身也要谨慎看待。行业分类由协会根据公司的收入结构来定,公司转型以后,标签可能滞后;年报里讲得最多的业务,也不一定是收入占比最大的那块。我们没有像 TypeSafe 原文那样先把「文本不支持标签」的样本筛掉,所以下面的准确率里包含了这部分标签噪声。
160 家公司;摘要一节平均 4529 字,截取前 1500 字送入160 家公司落在 45 个大类上,其中 110 家属于制造业(C),这和 A 股的真实构成一致。127 家的这一节超过 1,500 字,被截断了。很多公司在开头先写一大段行业形势,比如平煤股份先写全国原煤产量,再写「公司主营业务为煤炭开采、洗选加工和销售」。截断是有意的,因为状态过长时准确率会下降。
问一个 Choice,读它的置信度
91 个选项放进同一个 Choice,一次请求就能问完。Choice 最多支持 255 个选项,91 个还远没到上限。
答案里有三样东西:choice 是首选的大类,probabilities 是 91 个大类各自的概率,confidence 描述这组概率有多集中。我们用 confidence,而不是首选项自己的概率。计算公式 (n × 最高概率 − 1) / (n − 1) 见 置信度。
QUESTION = "这家公司主要属于哪个行业大类?请依据摘要中描述的公司自身经营业务来判断。"


def ask(company: dict) -> dict:
    resp = client.system_one(
        state=company["text"][:MAX_CHARS],
        questions={"group": Choice(instructions=QUESTION, criteria=OPTIONS)},
        model=MODEL,
    )
    ans = resp.answers["group"]
    return {"group": ans.choice.split()[0], "confidence": ans.confidence}
有把握报大类,没把握报上一级
下面这个函数就是整套做法。置信度不低于阈值时报告大类,低于阈值时,把同一个答案换成它的上一级报告。
这样每家公司都会拿到一个能用的标签。没把握的公司不会被丢掉,也不会被送去重跑,只是得到一个粗一级的答案。如果粗一级的标签对你的业务来说没用,这个分支就是转人工的地方。
def classify(company: dict) -> dict:
    a = ask(company)
    sure = a["confidence"] >= CONFIDENT
    return {
        "level": "大类" if sure else "上一级",
        "label": a["group"] if sure else parent_of(a["group"]),
        "confidence": a["confidence"],
        "group": a["group"],
}最有把握的三家:
平煤股份 conf 0.60 → 大类 B06 (煤炭开采和洗选业;标注 B06)
岳阳林纸 conf 0.52 → 大类 C22 (造纸和纸制品业;标注 C22)
世荣兆业 conf 0.50 → 大类 K70 (房地产业;标注 K70)
最没把握的三家:
悦安新材 conf 0.07 → 上一级 CH 电气、电子及通讯(模型首选 C39 计算机、通信和其他电子设备制造业;标注 C33 金属制品业)
绿能慧充 conf 0.07 → 上一级 CH 电气、电子及通讯(模型首选 C38 电气机械和器材制造业;标注 C38 电气机械和器材制造业)
外高桥 conf 0.08 → 上一级 K 房地产业(模型首选 K70 房地产业;标注 F51 批发业)置信度的高低,和人读原文时觉得的难易是一致的。最有把握的三家都只有一种主业:煤矿、纸厂、房地产开发商。最没把握的三家,难处都能在原文里读出来:
- 悦安新材:卖的是羰基铁粉、雾化合金粉,但原文花了大量篇幅写下游的电子元器件、3C 精密件、汽车零部件。模型的前三名分给了电子设备、黑色冶炼和有色冶炼,每个只有 0.06–0.08。
- 绿能慧充:前 1,500 字几乎全是新能源汽车保有量和充电桩数量这类行业统计。模型首选的方向是对的(C38 电气机械),但只得了 0.08,置信度很低。
- 外高桥:原文写的是「外高桥区域的重要开发主体」和「园区开发运营」,模型选了房地产业。它的标签是批发业,因为收入里有大量贸易业务,而这部分在截取的前 1,500 字里没有出现。
和 TypeSafe 原文的不同:置信度的绝对值低得多。 原文在 75 个 SIC 大类上有一半申报的置信度 ≥ 0.9。象信一号 1.0 在 91 个选项上把概率摊得更开:160 家里最高只有 0.60,中位数是 0.21。所以 0.9 这个阈值在这里不适用,一家都过不了。我们按原文的思路,改用「大约分成两半」的点,也就是 0.2。这个阈值是看着这 160 家的结果选的。用在你自己的数据上时,应该拿一份带标注的样本重新定,见 用标注数据定阈值。绝对值低不影响这套做法,要紧的是它能不能把样本排好序。下一节回答这个问题。
退一级换来了什么
把全部 160 家公司对照标注的大类打分,比较两种策略:每家都报大类,或者置信度低于 0.2 时改报上一级。
def correct(company: dict, result: dict) -> bool:
    gold = company["capco_code"]
    if result["level"] == "大类":
        return result["label"] == gold
return result["label"] == parent_of(gold)每家都强制报告大类 102/160 正确
其中有把握的 85 家 64/85 正确
没把握的 75 家 38/75 正确
没把握时退一级回答 111/160 个有用答案
没把握的 75 家退一级后 47/75 正确有把握的 85 家,大类四次里对三次(75%)。没把握的 75 家,硬报大类只有一半对(51%),改报上一级后升到 63%。
TypeSafe 原文里退一级的收益更大,从 40% 升到 70%。这里差距小一些,原因是这套分类的上一级本身就很细:制造业被拆成 10 个中间组,模型在相邻的中间组之间也会犹豫,典型的就是「金属、非金属」和「电气、电子及通讯」之间。
准确率与覆盖率
阈值不一定取 0.2。把它从 0 扫到 0.5,可以看到自动通过的比例和自动通过部分的准确率怎样此消彼长。这张表和图都是用同一批 160 次调用的缓存重新计算的,不需要额外请求。
| 阈值 | 自动通过 | 覆盖率 | 自动部分大类准确率 | 其余报大类 | 其余报上一级 |
|---|---|---|---|---|---|
| 0.00 | 160 | 100% | 64% | – | – |
| 0.10 | 155 | 97% | 64% | 60% | 60% |
| 0.15 | 130 | 81% | 69% | 40% | 50% |
| 0.20 | 85 | 53% | 75% | 51% | 63% |
| 0.25 | 57 | 36% | 82% | 53% | 65% |
| 0.30 | 38 | 24% | 82% | 58% | 69% |
| 0.35 | 16 | 10% | 100% | 60% | 69% |
| 0.40 | 9 | 6% | 100% | 62% | 71% |
| 0.50 | 4 | 2% | 100% | 63% | 72% |
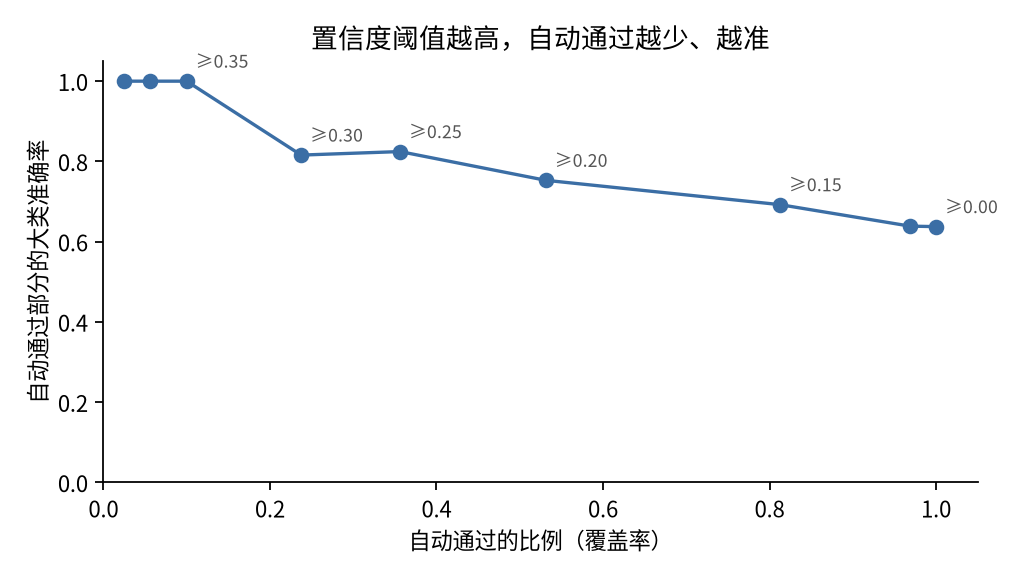
阈值越高,自动通过的越少,也越准。置信度 ≥ 0.35 的 16 家全部分对。这正是置信度该起的作用:它的绝对值不必接近 1,只要能把样本排好序,就可以用来路由。
成本
160 次调用共 695,932 个输入 token。按 ¥0.042 / 百万输入 token(输出免费)计算,一共约 ¥0.029,平均每家公司约 ¥0.0002。每次请求平均约 4,350 个输入 token:前 1,500 字的状态,加上每次都要重新发送的 91 个选项描述。运行时服务正同时承接其他批量任务,模型耗时的中位数是 3,983 ms。
讨论
- 为什么有效。 一次 Choice 返回的不只是一个答案,还有一整条分布。「首选对不对」的信息就藏在这条分布有多集中里。再配合标签体系的层级,拿不准时换成父节点,就能在不增加请求的前提下,给每家公司一个可用的标签。
- 局限。
- 象信一号 1.0 在几十个选项上给出的置信度,绝对值偏低。换一个数据集,阈值就要重新定。
- 标签是协会按收入结构定的,而年报文字更偏重「讲故事」。两者不一致的样本,按上面的算法算错,但未必是模型错了。
- 我们只送前 1,500 字,丢掉了后半部分的业务细节。
- 可以怎么改。
- 什么时候不该这么用。 如果下游不能接受「粗一级」的答案,比如必须精确到大类才能开票或报税,那就应该把没把握的分支直接转人工,而不是退一级。如果选项之间没有层级关系,就没有「上一级」可退,只能按置信度决定自动处理还是复核,见 置信度门控路由。
完整代码
完整代码、数据(160 家公司的摘要文本与标签、两份分类表)和运行结果:https://github.com/xiangxinai/xiangxin-cookbooks/tree/main/classification_using_confidence
prepare_data.py:抽样、下载年报摘要、截取与去泄露;main.py:提问、分级报告、阈值扫描与作图;results/:cache.json(每家公司的首选、置信度和前五名概率)、summary.json、run.log、coverage_accuracy.png。