SDE 级联
结构化数据抽取(Structured Data Extraction,SDE)有一个老矛盾:推理模型抽得准,但又慢又贵;不开思考的小模式便宜,却会犯错。级联的思路是:
- 先用便宜的模型抽取;
- 用象信对抽出来的每个字段问几道窄而具体的是非题(Noul),比如「这个值在原文里有依据吗?」「原文其实提到了,留空是不是错了?」,每道题返回一个校准过的 P(出错);
- 只要有一个字段的 P(出错) 超过阈值,就把这条记录交给推理模型重抽;否则直接用便宜的结果。
本篇在百度 DuEE 1.0 中文新闻事件抽取数据的 100 条样本上把这个流程完整跑一遍,并扫描阈值,看成本和质量怎么取舍。
一句话结论(全部来自真实运行):这一次级联没有带来收益。
- 推理模式并不比便宜模式抽得准:字段级 F1 平均 0.7935 对 0.7934,完全正确的记录 31 对 35 条;逐条看,推理模式更好 18 条、更差 21 条、一样 61 条。它的成本(按官方价目折算)却是 7 倍(每千条 ¥6.78 对 ¥0.97)。
- 象信的核验信号在这份数据上分不开对错:以「便宜模式这条记录不完全正确」为正例,逐字段最大 P(出错) 的 AUC 只有 0.399,整体判断为 0.456,都不比随机好。按原文的阈值 0.7,100 条里有 82 条被升级,质量反而降到 0.758。
- 但并不是完全没有可用的东西:8 类逐字段问题里有 6 类单独看 AUC 在 0.65–0.70,拖垮闸门的是一道双重否定的「不合理」题(它对 96.5% 的正确字段都给出 > 0.7)和一道「留空是否错误」题(AUC 0.047,几乎完全反向)。下文逐项拆开。
- 如果有一个完美的路由器,只把推理模式确实更好的 18 条送上去,质量可以到 0.857——空间是有的,只是这一版核验信号抓不住它。
使用的模型与价格
| 角色 | 模型 | 价格(元 / 百万 token) |
|---|---|---|
| rung 0:便宜抽取 | DeepSeek-V4.1-Flash(自部署,vLLM),关闭思考模式 | 输入 2,输出 8 |
| rung 1:推理抽取 | 同一模型,打开思考模式 | 同上;思维链计入输出 token |
| 核验 | 象信 xiangxin-latest | 输入 0.042,输出免费 |
两级抽取都跑在我们自部署的 DeepSeek-V4.1-Flash 上(vLLM,OpenAI 兼容接口),成本按 DeepSeek 官方 API 价目折算:deepseek-flash 高峰时段价,输入(缓存未命中)¥2 / 百万 token、输出 ¥8 / 百万 token,取自其官方价目页(2026-09-25 查询);空闲时段为一半。公式:成本 = 输入 token × 2 / 10⁶ + 输出 token × 8 / 10⁶。DeepSeek 在同一个模型上提供「思考 / 非思考」两种模式,所以两级用的是同一个模型的两种模式:单价相同,差别在于思考模式会多出大量思维链 token(本次平均每条输出 766 token,非思考模式 46 token),也慢得多。
和 TypeSafe 原文一样,两级抽取都用纯文本模式:不用 JSON Output、不用工具调用。原因是我们要检验的是语义错误(编造、张冠李戴、漏抽),而不是格式错误;一个模型如果连 JSON 都写不对,通常说明它已经彻底糊涂,约束解码也救不回来。(本次 200 次抽取中只有 1 次回复无法解析为 JSON,按空抽取处理。)
环境准备
pip install xiangxin-sdk openai matplotlib pandas pyarrow
export XIANGXIN_API_KEY="sk-xx-..."
export LLM_BASE_URL="https://api.deepseek.com" LLM_API_KEY="sk-..." LLM_MODEL="deepseek-flash"   # 或你自部署的 OpenAI 兼容地址
数据
nlhappy/DuEE(Hugging Face,MIT 许可),即百度 DuEE 1.0 中文事件抽取数据:句子来自百度信息流新闻,人工标注了事件类型和各论元角色的原文片段。它共 65 个事件类型,每个类型有固定的论元角色表,天然就是一份「Schema + 原文 + 标准答案」。
我们从验证集(1,453 句)里构造 100 条抽取任务(prepare_data.py):
- 只取恰好含一个事件、且每个角色最多出现一次的句子,事件类型至少有 3 个角色;
- 每个事件类型最多取 3 句,固定种子打乱后取 100 条,覆盖 52 个事件类型;
- Schema 列出该事件类型在训练集 + 验证集中出现过的全部角色,原文没有提到的角色,标准答案是空字符串。100 条记录共 347 个字段,其中 156 个标准答案为空——正确的抽取器必须学会「不编」。
一条样本长这样:
{
  "id": "duee-val-003",
  "prompt": "从这条新闻中抽取「组织关系-裁员」事件的信息。",
  "schema": {
    "title": "组织关系-裁员",
    "type": "object",
    "properties": {
      "裁员方":   {"type": "string", "description": "「组织关系-裁员」事件中的「裁员方」,照抄原文片段;原文没有提到时返回空字符串。"},
      "裁员人数": {"type": "string", "description": "…"},
      "时间":     {"type": "string", "description": "…"}
    }
  },
  "content": "据英国《卫报》报道,WeWork的职员透露,该公司最快在本周裁员至少2000人,占公司职员总数的13%。",
  "gold": {"裁员方": "WeWork", "裁员人数": "2000人", "时间": ""}
}
标注本身也有噪声
DuEE 的标注并不完美。比如 duee-val-003 里的「本周」没有被标成「时间」,duee-val-000(「沭阳约谈重点木材加工企业……」)里的「沭阳」没有被标成「约谈发起方」。这类样本上,一个「多抽了一个合理值」的模型会被扣分。我们不挑样本、不改标注,照原样打分,并在结果里把这类情况单独指出来。
打分:每个字段算字符级 F1(去掉空白和标点后比较;标准答案和抽取结果都为空记 1,一空一不空记 0),一条记录的质量是其字段 F1 的平均,全体质量是 100 条的平均。另报「整条记录完全正确」的条数。
第一步:用便宜的模式抽取
EXTRACT_SYSTEM = "你从文档中抽取结构化数据。只返回原文支持的取值,遵守 Schema 及字段说明中规定的取值格式。"

def extract(tier: str, rec: dict) -> dict:
    user = (
        f"{rec['prompt']}\n\n只返回一个符合下面 JSON Schema 的 JSON 对象:\n"
        f"{json.dumps(rec['schema'], ensure_ascii=False, indent=2)}\n\n文档:\n{rec['content']}"
    )
    kwargs = dict(model=LLM_MODEL, messages=[
        {"role": "system", "content": EXTRACT_SYSTEM},
        {"role": "user", "content": user},
    ])
    # 自部署 vLLM 上用 chat_template_kwargs 开关思考模式;
    # 官方 API 则用 extra_body={"thinking": {"type": "enabled" / "disabled"}}
    if tier == "mini":      # rung 0:关闭思考
        kwargs |= {"temperature": 0, "extra_body": {"chat_template_kwargs": {"thinking": False}}}
    else:                   # rung 1:打开思考
        kwargs |= {"extra_body": {"chat_template_kwargs": {"thinking": True}}}
    text = llm.chat.completions.create(**kwargs).choices[0].message.content
    return parse_json(text)   # 只去掉 ``` 围栏;解析失败按空抽取处理(所有字段都会被核验)
第二步:用象信逐字段核验
每个字段一组 Noul,问法统一成「true = 有问题、该升级」,并写明 true / false 各指什么:
- 非空字段问 7 道:与字段名 / 说明不符、类型不符、不合理、编造、取自无关文字、漏抽、格式违规;
- 空字段只问 1 道:原文其实有这个信息,留空是错的吗?
- 另加一道整条记录的总判断
__overall__::judge,只用来和逐字段信号做对比,不参与闸门。
所有问题放在同一个请求里,一条记录一次象信调用。
from xiangxin import Noul, XiangxinClient

MAIN_QUESTIONS = {
    "name_desc_mismatch": ("`extracted_field` 是否与 `field_spec` 中的 `path` 或 `description` 对不上?"
                           "`description` 为空时只按 `path` 判断。",
                           {"true": "`extracted_field` 与字段名或其说明不符", "false": "`extracted_field` 与字段名和说明相符"}),
    "type_mismatch":      ("`extracted_field` 是否违反了 `field_spec` 中声明的 `type`?",
                           {"true": "`extracted_field` 违反了声明的类型", "false": "`extracted_field` 符合声明的类型"}),
    "unreasonable":       ("对这个 `field_spec`,一个讲道理的人是否不会抽出 `extracted_field` 这个值?",
                           {"true": "讲道理的人不会抽出这个值", "false": "这个抽取是合理的"}),
    "hallucinated":       ("`extracted_field` 是否在原文中找不到依据,或者原文里根本没有?",
                           {"true": "`extracted_field` 是编造的:原文不支持或没有出现", "false": "`extracted_field` 有原文依据"}),
    "off_target":         ("原文是否并没有真正报告 `field_spec` 描述的内容,这个值只是从无关文字里摘出来的?",
                           {"true": "原文并未真正提供这个字段,取值来自无关文字", "false": "原文确实报告了这个字段"}),
    "incomplete":         ("`extracted_field` 是否漏掉了原文支持的取值(注意 `field_spec` 是否 `required`)?",
                           {"true": "该字段被错误地留空,或缺少原文支持的内容", "false": "该字段完整抽取了原文支持的取值"}),
    "format_violation":   ("`extracted_field` 是否违反了 `description`、Schema `type` 与抽取要求所隐含的格式或约束(如照抄原文、单位、枚举)?",
                           {"true": "`extracted_field` 违反了隐含的格式或约束", "false": "`extracted_field` 满足格式与约束"}),
}
ABSENCE_QUESTION = "`extracted_field` 为空。原文是否包含 `field_spec` 所描述的信息,因而留空是错的?"
ABSENCE_CRITERIA = {"true": "漏掉了应抽取的值", "false": "留空是正确的"}
OVERALL_JUDGE = ("这条抽取结果是否有误——存在原文不支持或不符合 Schema 的取值、缺失或错误的必填信息、"
                 "或者编造的字段——因而应该交给更强的模型重做?")
OVERALL_CRITERIA = {"true": "这条记录抽取有误", "false": "这条记录抽取正确"}


def build_questions(schema: dict, record: dict) -> dict[str, Noul]:
    questions = {"__overall__::judge": Noul(instructions=OVERALL_JUDGE, criteria=OVERALL_CRITERIA)}
    for name in schema["properties"]:
        value = record.get(name, "")          # 模型漏写的字段按空值处理
        spec = field_spec(schema, name)       # {"path", "type", "description", "required"}
        if value in (None, "", [], {}):
            questions[f"{name}::absence_wrong"] = Noul(
                instructions={"field_spec": spec, "extracted_field": value, "main_question": ABSENCE_QUESTION},
                criteria=ABSENCE_CRITERIA,
            )
            continue
        for metric, (question, criteria) in MAIN_QUESTIONS.items():
            questions[f"{name}::{metric}"] = Noul(
                instructions={"field_spec": spec, "extracted_field": value, "main_question": question},
                criteria=criteria,
            )
    return questions


def verify(rec: dict, record: dict) -> dict[str, float]:
    state = {
        "system_message": EXTRACT_SYSTEM,
        "instruction": rec["prompt"],
        "source_text": rec["content"],
        "schema": rec["schema"],
        "extraction": record,
    }
    answers = XiangxinClient().system_one(state=state, questions=build_questions(rec["schema"], record)).answers
    return {qid: a.noul for qid, a in answers.items()}
这里用到了 结构化 instructions:field_spec、extracted_field 作为对象放进问题里,问题正文用反引号引用它们的键名;整条抽取任务(原文、Schema、抽取结果)作为结构化 state 一次发送。
逐字段拆开问,是这个方法的关键。 一道「这条记录好不好」的总问题,得到的是一个含糊的分数;拆成「这一个字段、这一种错误」的窄问题,信号会集中落在真正出错的字段上,也能直接告诉你错在哪。
第三步:升级闸门
闸门是 any_flag:任何一个字段的任何一道题 P(出错) 超过阈值 FIRE_T = 0.7,就升级。用 max 而不是平均,是为了让一个有把握的红旗不被其余几十道「没问题」平均掉。
fired = {q: p for q, p in checks.items() if not q.startswith("__overall__") and p > FIRE_T}
final = extract("reasoning", rec) if fired else mini_record
走一遍:一条被升级的记录
按 id 顺序,第一条「闸门触发、且推理模式确实提高了质量」的记录是 duee-val-008(事件类型「灾害/意外-洪灾」):
中新社福州6月24日电 (记者 龙敏)受自21日起的新一轮强降雨持续影响,福建多地受灾。福建省防汛办24日披露,截至当天上午,福建已转移民众逾3.5万人。
| 字段 | 标准答案 | 便宜模式 | 推理模式 |
|---|---|---|---|
| 地点 | 福建多地 | 福建 | 福建多地 |
| 时间 | (空) | 6月24日 | 自21日起 |
| 死亡人数 | (空) | (空) | (空) |
| 受伤人数 | (空) | (空) | (空) |
象信对便宜模式结果的核验(一次请求,17 道题,按 P(出错) 从高到低):
qid                                P(出错)
地点::unreasonable                    0.76  <== 触发
时间::unreasonable                    0.69
死亡人数::absence_wrong                 0.52
受伤人数::absence_wrong                 0.52
__overall__::judge                  0.46
时间::name_desc_mismatch              0.31
时间::off_target                      0.30
地点::name_desc_mismatch              0.28
地点::off_target                      0.24
时间::incomplete                      0.24
地点::incomplete                      0.23
时间::hallucinated                    0.23
时间::format_violation                0.23
时间::type_mismatch                   0.22
地点::type_mismatch                   0.17
地点::hallucinated                    0.17
地点::format_violation                0.17
闸门因为 地点::unreasonable = 0.76 触发,推理模式把「福建」改成了「福建多地」,这条记录的质量从 0.67 升到 0.75。但也要看清楚:
- 真正的问题是「时间」——标准答案认为这条新闻没有给出洪灾时间(「6月24日」是发稿日,「自21日起」是降雨起始),两级都填了值。而针对「时间」的
hallucinated、off_target只有 0.23、0.30,没有抓到。 - 触发闸门的
unreasonable题,在下文会看到,对几乎所有填了值的字段都给出高分。所以这次「升级得对」主要是运气。
结果:100 条的成本与质量
各方案在 100 条上的表现(原始输出:results/summary.json)。质量是字段级字符 F1 的平均;成本按上文价目折算,级联的成本包含便宜模式、象信核验和被升级记录的推理模式;耗时是在共享 GPU 上 4 路并发时的平均单条墙钟时间,仅供相对比较。
| 方案 | 质量 | 完全正确 | 每千条成本 | 平均耗时 |
|---|---|---|---|---|
| 便宜模式单独 | 0.7934 | 35 / 100 | ¥0.97 | 13.0 s |
| 推理模式单独 | 0.7935 | 31 / 100 | ¥6.78 | 38.1 s |
| 级联,any_flag > 0.7(原文阈值),升级 82 条 | 0.7583 | — | ¥6.21 | 45.9 s |
| 级联,any_flag > 0.85,升级 20 条 | 0.7849 | — | ¥2.51 | 23.3 s |
| 级联,any_flag > 0.9,升级 3 条 | 0.7890 | — | ¥1.36 | 16.9 s |
| 神谕路由(只升级推理模式确实更好的 18 条,事后才知道) | 0.8574 | — | ¥2.42(仅大模型) | — |
象信核验本身:100 次调用、共 1,515 道 Noul、234,305 个输入 token,合计 ¥0.0098(每千条 ¥0.098),模型平均耗时 2.3 秒。
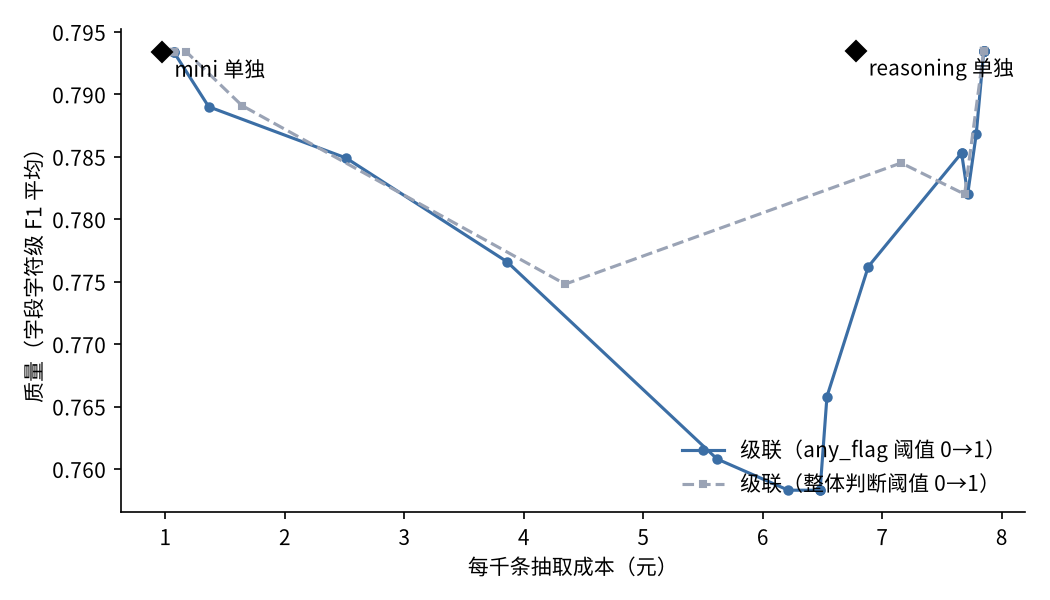
黑色菱形是两级单独使用;蓝线是逐字段 any_flag 闸门在阈值 0 → 1 上的全部配置,灰色虚线是用整体判断 __overall__::judge 做闸门的对照。TypeSafe 原文里,级联的前沿落在每个单独模型的左上方;这里正相反:两条曲线都在两个菱形连线的下方,没有任何阈值能同时比便宜模式更准、比推理模式更省。
原因有两层,下面分开看。
原因一:推理模式在这份数据上不更准
逐条比较两级:推理模式更好 18 条,更差 21 条,一样 61 条。DuEE 的句子很短(平均 49 字),答案是原文片段,错误大多出在片段边界和标注口径上:「至少2000人」还是「2000人」、「本周」算不算时间、「福建」还是「福建多地」。这些不是「想得更久」能解决的问题,思考模式有时更「合理」地多填一个时间,反而与标注不一致。级联的前提是「贵的那一级确实更好」,这里这个前提不成立。
原因二:这一版核验信号分不开对错
把 347 个字段按「便宜模式这个字段抽得对不对」分组,看每一类问题的区分能力(AUC,0.5 为随机;results/analysis.json):
| 问题 | 适用字段 | AUC | 正确字段中 P > 0.7 的比例 | 错误字段中 P > 0.7 的比例 |
|---|---|---|---|---|
| format_violation | 填了值的 178 个 | 0.700 | 0% | 0% |
| hallucinated | 同上 | 0.682 | 0% | 0% |
| type_mismatch | 同上 | 0.677 | 0% | 0% |
| incomplete | 同上 | 0.671 | 0% | 0% |
| name_desc_mismatch | 同上 | 0.657 | 0% | 0% |
| off_target | 同上 | 0.647 | 0% | 0% |
| unreasonable | 同上 | 0.429 | 96.5% | 89.1% |
| absence_wrong | 留空的 169 个 | 0.047 | 0% | 0% |
- 六类窄问题是有信号的(AUC 0.65–0.70),但它们的概率全都落在 0.7 以下,按原文的阈值永远不会触发。
unreasonable一道题决定了闸门:它的问法是双重否定(「一个讲道理的人是否不会抽出这个值?」),象信对它几乎总是回答「是」,正确字段中 96.5% 超过 0.7。于是 any_flag 在 0.7 附近基本等于「只要填了值就升级」。absence_wrong几乎完全反向(AUC 0.047):它的概率大多停在 0.5 附近,而在便宜模式整条记录大面积留空(通常正是漏抽)的时候反而更低。便宜模式漏抽的 35 个字段,没有一个被标红。
事后把这两类问题去掉、只用其余六类的最大值做闸门,记录级 AUC 也只有 0.507。阈值 0.40 时只升级 4 条,质量 0.8008——这是在同一批数据上事后挑出来的配置,4 条样本也说明不了什么,我们不把它当结论。
对核验题设计的启示
这与已知短板里的两条吻合:字面理解(双重否定、「留空是不是错的」这种绕一道弯的问法容易被读反)和单步判断之外的推理(判断「原文是否含有某字段应有的值」需要先理解整个事件结构)。在你自己的数据上用这个方法时,先把每道核验题单独拿到有标签的样本上量一下 AUC,只保留有信号的题,并按每道题的实际分布设阈值,而不是统一用 0.7。
计划与实际调用量一致:DeepSeek 200 次(100 条 × 两种模式;推理模式对全部 100 条都跑,是为了离线扫描阈值时知道「如果升级会得到什么」,真实部署时只有被升级的记录才需要调用),象信 100 次。
什么样的核验信号才好用
- 窄,并且有据可查。 一个字段、一种错误、对照原文回答,而不是笼统地问「抽得好不好」。笼统的问题只会给出含糊、难以校准的分数。
- true = 有问题,并写清 criteria。 让「该升级」一律是 true,并把 true / false 各代表什么写进
criteria,所有信号就能用同一个阈值合并。 - 先逐字段,再用 max 合并。 逐字段的信号稀疏而明确,也能定位错误;max 保证一个有把握的红旗足以升级。
- 独立且便宜。 核验者要和抽取者不同,才能发现抽取者自己的盲区;它还必须足够便宜,否则就没有可省的钱。象信一条记录一次请求,所有问题并行回答,输出 token 不收费。
- 能分开对错。 好的信号在真错误上高、在正确结果上低,一个阈值就能把「接受」和「升级」干净地分开——这正是级联曲线能往左上方推的原因。
局限与什么时候不该用
- 象信是一个系统一模型,擅长「这个值在原文里有没有」这类单步判断;需要跨句推理、数值换算的核验(例如「金额是否等于单价乘数量」)应放在代码里做,见已知短板。
- 级联要成立,需要两个前提同时成立:贵的一级确实更好,并且核验信号能指出便宜一级错在哪里。本文的数据上两个前提都不成立,所以不该这样用。先各花几十条样本把这两件事量出来,再决定要不要搭级联。
- 如果便宜的一级已经几乎不出错,核验的钱就是纯开销;反过来,如果它几乎总是出错,直接用推理模型更省事。级联最有价值的区间,是便宜一级「大部分对、少部分错、而且错得不规律」的时候。
- 对以片段边界、标注口径为主要误差的任务(如 DuEE),与其升级模型,不如把口径写进 Schema 的
description(例如「人数只写数字和量词,不含『至少』」)。 - DuEE 的句子很短(平均 49 字)。长文档抽取时,先把与字段相关的段落检索出来再核验,见 RAG 段落分类。
完整代码
https://github.com/xiangxinai/xiangxin-cookbooks/tree/main/sde_cascade
prepare_data.py:从 DuEE 构造 100 条抽取任务(data/records.jsonl)main.py:两级抽取、象信核验、阈值扫描与作图;所有调用缓存在results/cache.jsonanalyze.py:只读缓存的离线分析(逐题 AUC、错误类型、神谕上界),输出results/analysis.json